DocLoader.
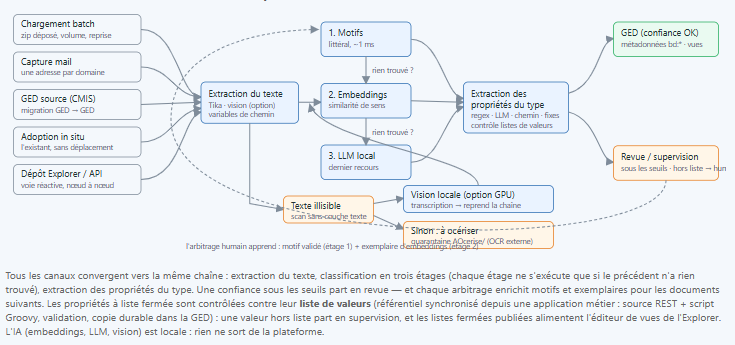
docLoader est un Outil de classement documentaire assisté par LLM local, en deux modes portés par un même binaire Java :
- Chargeur batch : chargement en masse d’une arborescence de fichiers dans une GED, Alfresco ou Efalia, avec plan de classement, extraction de métadonnées et dépôt de chaque document dans la bonne zone, en direct par l’API de la GED ou en préparation pour son outil d’import natif.,
- Service continu blueDoc (profil Spring `bluedoc`) : capture au fil de l’eau depuis des boîtes mail, une GED source par CMIS ou les dépôts du client Explorer, classement réactif des documents déposés dans le dépôt, supervision par exception, indexation sémantique et adoption de l’existant, avec dépôt direct dans Alfresco et métadonnées extraites.
Toute la chaîne de classement s’exécute sur la plateforme : aucun texte de document ne sort vers un service extérieur.
docLoader s’adresse à l’archiviste ou au gestionnaire documentaire qui doit faire entrer des documents dans une GED avec le bon type, les bonnes métadonnées et les bons droits, qu’il s’agisse d’une reprise de masse ou d’un flux quotidien.
Deux modes, un seul binaire
| Chargeur batch | Service continu blueDoc | |
|---|---|---|
| Cycle de vie | Campagne : on charge, on arrête | Service permanent aux côtés du dépôt Alfresco |
| Sources | Répertoire ou archive zip | Les mêmes, plus boîtes mail, GED source par CMIS, dépôts du client Explorer |
| Cible | Staging pour l’import natif Alfresco ou Efalia, ou dépôt direct Alfresco ou Efalia Doc | Dépôt direct Alfresco, classement porté par les métadonnées, zone de sécurité par classe de sensibilité |
| Classement | Au chargement | Au chargement et à la demande du dépôt, document par document |
| Supervision | Piles de revue et écran de revue | Supervision par exception : le document est déposé, marqué à revoir, arbitré en place |
| Indexation sémantique | — | Index vectoriel alimenté en continu pour la recherche unifiée |
| Apprentissage | À la validation en revue | Idem, plus les reclassements faits dans la GED |
Modèle documentaire
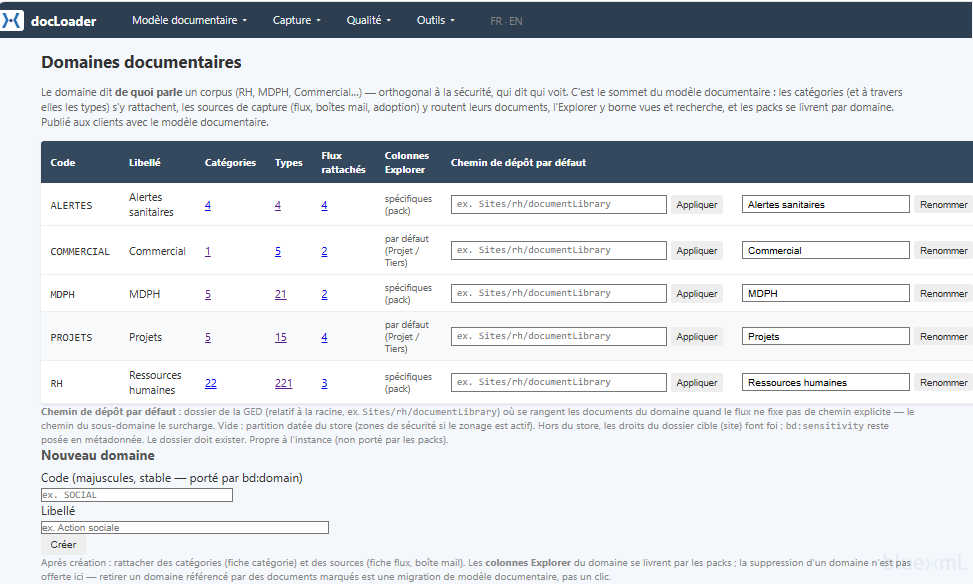
- Domaines, catégories et types de documents, avec sous-domaines de sécurité ; un domaine porte ses catégories, une catégorie ses types.
- Type de document : motifs de reconnaissance, propriétés à extraire, mapping vers la GED, classe de sensibilité, droits CAMS, durée de conservation et sort final.
- Propriétés d’extraction en cinq modes : expression régulière, LLM, variable du chemin, valeur fixe, saisie manuelle ; types texte, date et nombre ; propriétés multivaluées ; listes fermées statiques ou lues d’une application externe.
- Flux de capture : le chemin du fichier désigne la cible et fournit des variables réutilisées dans les métadonnées, avec héritage parent vers enfant.
- Packs : modèle documentaire versionné, importé, simulé et exporté ; un champ modifié sur l’instance n’est jamais écrasé par une nouvelle version du pack. Packs livrés : RH, MDPH, pilote commercial et projets.
- Paramétrage par écrans web, en français et en anglais.
Classement et extraction
- Extraction du texte par Apache Tika, une seule passe par fichier.
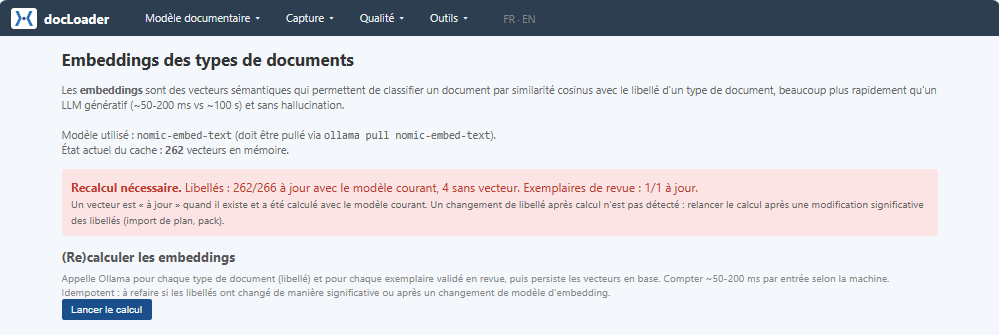
- Cascade en trois étages, chacun avec sa confiance : motifs, puis similarité d’embeddings avec les libellés et les exemplaires appris, puis LLM en deux phases, la catégorie puis le type. Les candidats sont bornés par le flux, le domaine et les indices.
- LLM local via Ollama, modèle choisi selon le matériel : un petit modèle sur CPU, un modèle plus large sur GPU. Sortie JSON contrainte, délais et parallélisme réglables.
- Déduplication des contenus identiques dans un lot.
- Découpage des scans en lot : un PDF contenant plusieurs documents séparés par des intercalaires à code-barres est éclaté en autant de documents, classés et chargés séparément.
- Documents sans couche texte : transcription par un modèle de vision local, texte réinjecté dans la cascade et conservé pour la recherche, classement proposé en supervision ; sans vision, mise en quarantaine.
- Extraction des propriétés d’un document en un seul appel, contrôle des listes fermées, rejet des valeurs qui ne respectent pas le type attendu.
- Contrôle de fraude par validateurs déterministes : clé du NIR, chiffres de contrôle des documents d’identité, cohérence des propriétés du fichier ; signalement, jamais de blocage.
- Métadonnées agent : extraction ciblée et agrégation par personne sur les types désignés, détection d’incohérences entre les pièces d’un même dossier.
Qualité et apprentissage
- Revue des classements sous les seuils de confiance, avec extrait du texte et meilleurs candidats ; validation, correction, approbation en masse, historique.
- Apprentissage à la validation : une phrase distinctive devient motif du type, le texte validé devient exemplaire d’embedding.
- Motifs proposés par un import de pack ou par un reclassement dans la GED, acceptés ou refusés un par un.
- Remise à zéro de l’apprentissage d’un domaine, modèle documentaire intact.
- Indicateurs : documents traités, part classée sans intervention, revus, en attente, erreurs.
- Test unitaire d’un document, d’un répertoire ou d’un découpage, avec le détail de chaque étape.
Chargeur batch
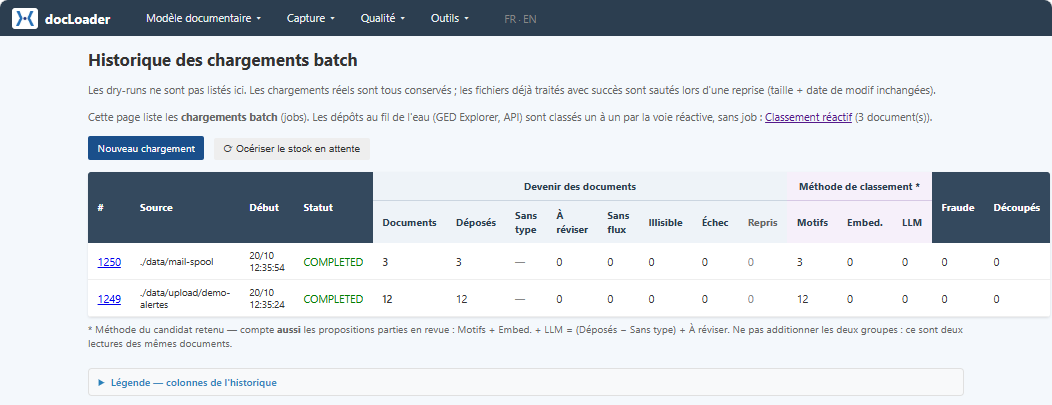
- Lancement sur un répertoire monté ou une archive téléversée, dry-run avec rapport complet, reprise sur empreinte, workers parallèles, file de jobs et annulation.
- Staging Alfresco pour l’outil d’import natif, avec métadonnées et permissions, et pose des droits CAMS après import.
- Staging Efalia par descripteurs XML, ou dépôt direct dans Efalia Doc avec résolution des gabarits et conversion des valeurs.
- Dépôt direct dans Alfresco par l’API REST, dossiers créés à la volée.
- Piles de revue sur le système de fichiers pour les documents sans flux, sans texte, sous le seuil ou sans type.
- Historique par job et par document : statut, type, méthode, confiance, note.
Service continu blueDoc
- Dépôt direct dans Alfresco avec classement porté par les métadonnées : catégorie, type, confiance, source, chemin d’origine, journal de transparence.
- Zonage de sécurité : la classe de sensibilité du type place le document dans une zone dont les droits sont provisionnés avant le premier dépôt.
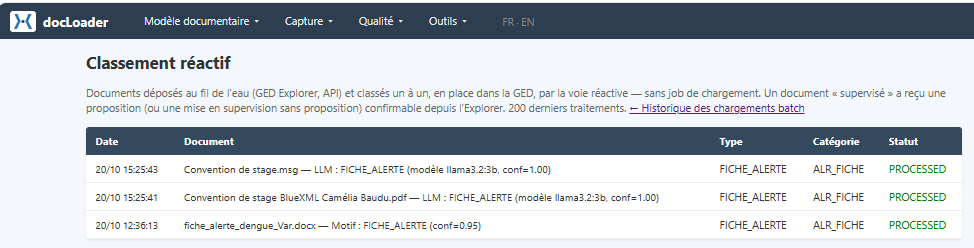
- Classement réactif : un document déposé par le client Explorer, par l’API ou par un autre canal du dépôt est classé en place, sans job.
- Connecteur mail : plusieurs boîtes IMAP, une adresse par domaine documentaire, pièces jointes filtrées et chargées en continu.
- Connecteur GED source : transfert depuis une autre GED par CMIS, avec chemin de départ, date plancher, limite, passes delta et reprise.
- Adoption de l’existant : annotation en place des documents déjà présents, sans déplacement ni copie, avec revue par échantillonnage et mode évaluation qui mesure l’accord avec le plan de classement physique.
- Boucle de retour : les reclassements faits dans la GED alimentent les motifs proposés.
- Indexation sémantique : fragments vectorisés en local et écrits dans l’index de la recherche unifiée, en continu et par réconciliation.
- Publication du modèle documentaire dans la GED pour les clients.
Exploitation et sécurité
- Base PostgreSQL, schéma versionné, sauvegarde et restauration documentées.
- Authentification sur tous les points d’accès, verrouillage après échecs répétés, délégation facultative des écrans à un fournisseur d’identité OpenID Connect.
- Secrets chiffrés au repos.
- Santé et métriques exposées pour la supervision.
- Livraison en archive avec guide d’exploitation, image Docker sans privilège, déploiement Kubernetes par le chart blueDoc.