
Vingt ans de déploiements de GED nous ont appris une chose : "le logiciel n'est presque jamais le problème. L'adoption l'est!"
- novembre 4, 2026
- Article, blueDoc, Efalia, GED (Gestion électronique Documentaire), GED Alfresco, Technique
On installe une GED solide, souvent Alfresco ou Efalia. On bâtit un beau plan de classement. On forme les équipes. Dix-huit mois plus tard, la moitié des documents dort sur les disques partagés et dans « Mes documents ». L’autre moitié est mal rangée. Beaucoup sont dupliqués, modifiés sans que personne ne sache quelle est la dernière version. Et personne ne retrouve rien sans aide.
La technologie a tenu ses promesses. L’organisation, non. Et greffer un chatbot IA sur la GED n’y changera rien.
C’est ce constat qui fonde l’approche blueDoc, posée au-dessus d’Alfresco ACS, autres GED à venir comme Efalia. L’idée directrice : utiliser l’IA non pas pour décorer la GED, mais pour supprimer les corvées qui la font échouer.
L'IA add-on contre l'IA qui change le métier
La vague actuelle consiste à greffer un assistant IA sur la GED existante. Résumé automatique, extraction de dates et de concepts, chatbot de questions-réponses : ces briques sont d’abord démontrées par les éditeurs (Alfresco, Efalia, SharePoint), puis reprises par les intégrateurs dans leurs offres « IA pour la GED ».
C’est utile. Mais le parti pris est toujours le même : on garde la GED telle quelle, et on ajoute par-dessus un assistant qui sait résumer, chercher et répondre. Ce qui fait vraiment souffrir reste intact. Il faut toujours classer à la main, maintenir un plan de classement, et former les gens à une interface qui n’est pas la leur.
L’IA « qui répond » ne résout pas l’adoption. Elle ajoute une couche de confort à un socle que les utilisateurs contournent déjà.
Notre pari est inverse. L’IA ne doit pas être une fonction de plus à apprendre. Elle doit travailler en arrière-plan, sur les fonctions de base de la GED, pour retirer du travail : classement, sécurité, versions, recherche, analyse. L’interface n’affiche d’ailleurs pas « l’IA ». Elle affiche des documents bien rangés.
Concrètement, cela se décline en 8 ruptures pour l’utilisateur.
1. Le « non-plan de classement » : classification automatique et vues métier
Le plan de classement arborescent partagé est le péché originel de la GED. Un arbre unique, figé, que chaque service voudrait organiser autrement, et que personne ne maintient.
blueDoc le supprime. Les documents ne sont pas rangés dans des dossiers : ils sont marqués par des métadonnées (domaine, catégorie, type, dossier, tiers, échéance, sensibilité). Les « dossiers » que voient les utilisateurs sont des vues, des requêtes recomposables à volonté : par agent, par affaire, par échéance, par type, par entité. Le même document apparaît dans toutes les vues où il a du sens, sans duplication. Changer d’axe de lecture n’est plus une migration. C’est un clic.
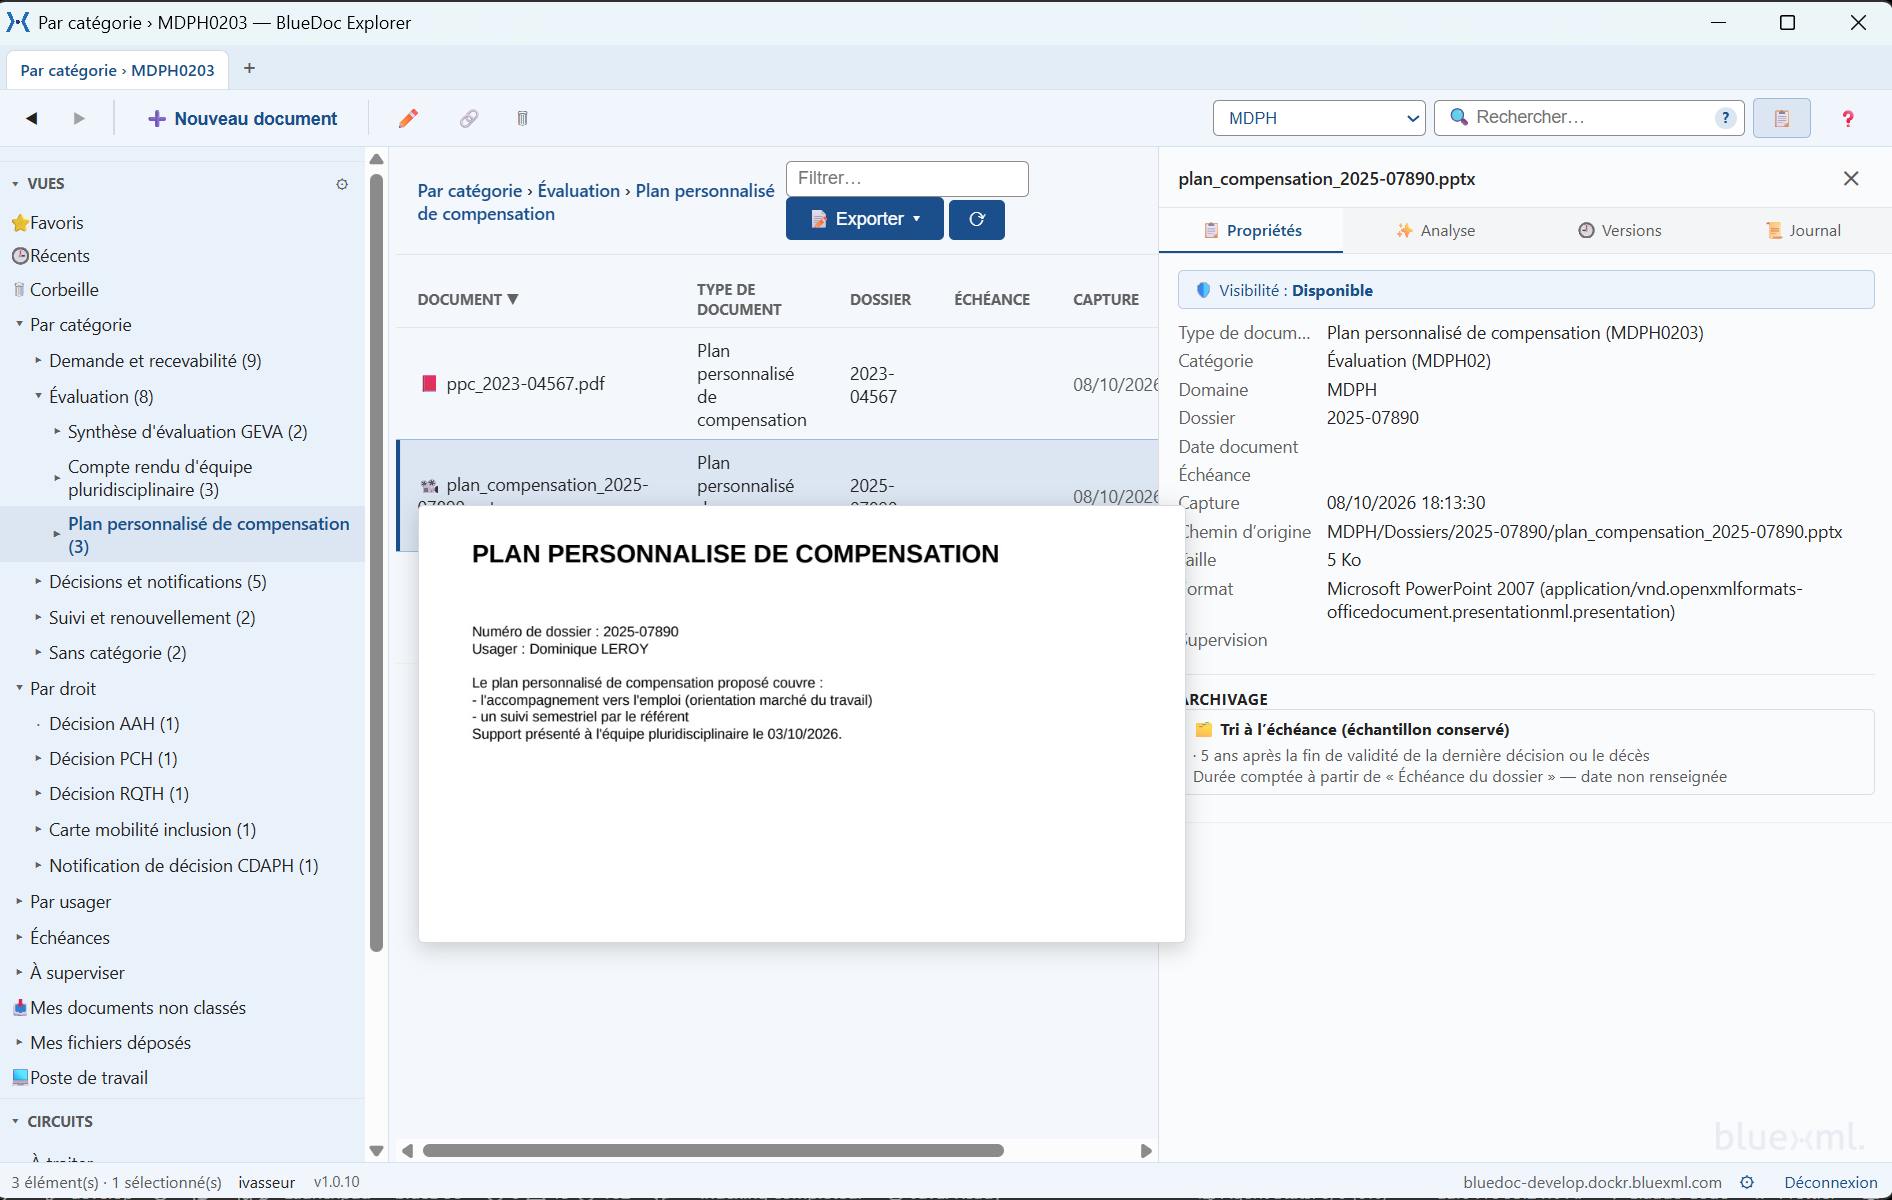
Le classement lui-même est automatique, par une chaîne 100 % locale en 3 étages. Chacun ne s’exécute que si le précédent n’a pas conclu :
- motifs (phrases, expressions régulières) : déterministe, instantané, explicable ;
- embeddings : similarité sémantique avec les vrais documents de chaque type ;
- LLM local en dernier recours.
La majorité des documents est typée sans modèle lourd, à coût quasi nul. Et l’on sait toujours pourquoi un document a été classé ainsi. Un document douteux passe en supervision, un clic le corrige, et la correction nourrit les motifs : le système apprend de chaque arbitrage. À comparer à un chatbot qui, lui, ne classe rien ; Il commente un rangement que quelqu’un a dû faire à la main.
2. Retrouver en langage naturel, pas en mots-clés
Classer sans effort n’a de valeur que si l’on retrouve sans effort. C’est l’autre moitié de la promesse, et la question que toute GED élude : combien d’heures à chercher ?
La recherche de blueDoc comprend la question posée en français : « les décisions AAH de cette année », « les factures du client ACME en retard », « les documents que j’ai chargés hier ».
Un moteur local en extrait des filtres métier (type, catégorie, tiers, période, périmètre « à moi »), affichés et rectifiables d’un clic. Le reste est cherché à la fois dans le texte (contenu, nom, titre, transcription des scans océrisés) et par similarité sémantique, les deux fusionnés et chaque résultat vérifié selon les droits.
L’utilisateur n’a pas à connaître vos codes ni votre plan de classement. Il pose sa question. Et tout reste local : ni la question ni le corpus ne sortent.
3. Une adoption « comme l'explorateur Windows »
La meilleure interface est celle que l’utilisateur connaît déjà. GED Explorer de blueDoc reprend les codes de l’explorateur Windows : arborescence de vues à gauche, colonnes triables, glisser-déposer, menu contextuel, multi-sélection, favoris, récents, corbeille, onglets, thèmes clair et sombre. Un agent est opérationnel en cinq minutes, sans formation à un portail métier.
La vue « Poste de travail » montre les fichiers locaux de l’utilisateur à côté des vues de la GED : un clic droit, « Classer en GED », et le document entre dans la chaîne de classement sans quitter l’outil. Le disque personnel cesse d’être un cimetière.
L’Explorer est conforme RGAA : navigation complète au clavier, lecteur d’écran, audit automatisé rejoué à chaque livraison, déclaration d’accessibilité publiée. Un portail que tout le monde peut utiliser, y compris les agents en situation de handicap.
Point d’architecture décisif : l’accès est 100 % API, sans montage réseau ni partage de fichiers exposé. Il existe en version web et également en client lourd avec mise à jour automatique.
Ces versions intègrent l’authentification unifiée (SSO) et l’édition en ligne souveraine (Collabora, OnlyOffice hébergés chez vous) et pour le client l’édition via les outils locaux installés (MS, LibreOffice, …).
4. La séparation métier : un vrai multi-domaine
RH, MDPH, marchés, courrier, action sociale, alertes sanitaires : chaque domaine a son vocabulaire, ses types, ses colonnes, ses vues et ses règles.
blueDoc traite le domaine comme un objet de première classe.
Un document porte son domaine, et l’Explorer borne les vues, la recherche, les colonnes et les types proposés au domaine concerné. Un gestionnaire RH ne voit pas le bruit de la MDPH.
Chacun travaille dans son univers, sur le même socle. On évite à la fois le silo (une GED par service) et la bouillie (tout dans le même arbre).
5. Une sécurité que les métiers comprennent : sensibilité et zone
Les ACL, les rôles, les groupes, l’héritage des permissions : un archiviste n’a pas à parler ce langage.
blueDoc expose un modèle compréhensible par le métier :
- chaque type de document porte une classe de sensibilité : privé, restreint, confidentiel, disponible
- au dépôt, le document tombe dans une zone de sécurité dont les droits sont provisionnés automatiquement
- la traduction « classe → groupes réels » reste propre à chaque organisation, jamais imposée.
Le métier décide qu’un certificat médical est « confidentiel ». L’organisation décide, une fois, qui compose le groupe qui y accède.
L’utilisateur ne choisit aucun droit : le type suffit.
La même classe gouverne l’IA : un document confidentiel ne part jamais vers un modèle distant.
Pour les déploiements en masse, une matrice CAMS (Consulter, Ajouter, Modifier, Supprimer par rôle) complète le dispositif.
6. Une analyse intégrée, cadrée, et multi-documents
L’assistant n’est pas une fenêtre de chat greffée. Il est intégré au poste de travail et cadré avec 2 modes de fonctionnement :
- IA 100 % locale : aucun texte ne quitte l’infrastructure, le mode souverain par défaut ;
- IA distante quand on veut un modèle plus puissant, avec pseudonymisation avant envoi via PromptCape : noms, personnes, organisations sont remplacés avant le départ et rétablis dans la réponse. Le modèle distant ne voit jamais vos tiers.
Le routage entre les deux est automatique, selon la sensibilité du document et la charge, et sa raison est tracée.
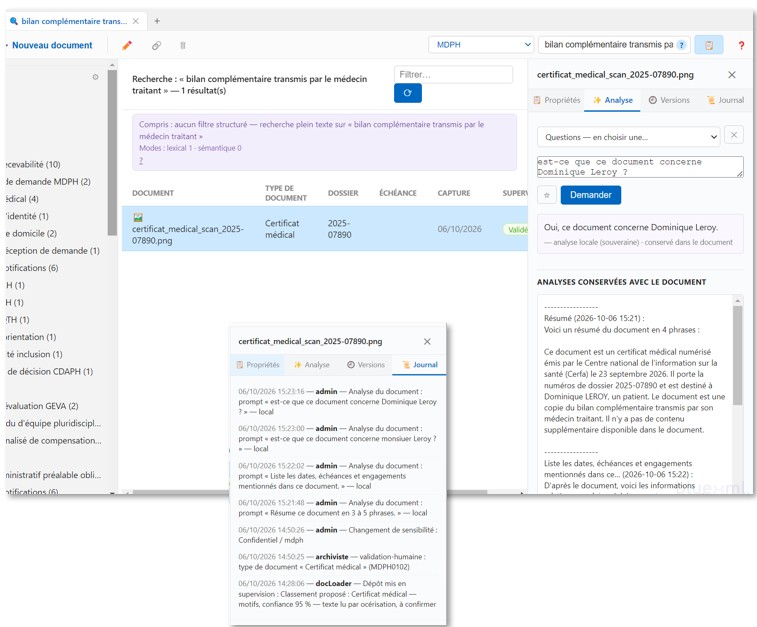
Et surtout, l’analyse est multi-documents : synthèse de toutes les pièces d’un même sujet (un usager, un agent, une affaire), questions ouvertes d’un document avec réponses sourcées dans le corpus, comparaison, extraction. Les échanges forment des fils d’analyse rattachés aux documents, exportables en Word.
L’assistant sait aussi remplir un modèle (bulletin, fiche de synthèse) depuis les pièces sélectionnées et le déposer comme un vrai document typé. Chaque résultat est une proposition tracée, jamais une action silencieuse.
7. Un versionnement transparent
Le versioning classique noie l’utilisateur sous les versions, une par sauvegarde, ou l’oblige à gérer des verrouillages.
blueDoc le rend transparent : une version par session d’édition, décidée à la clôture. Une retouche mineure ne crée pas de version, mais elle est tracée au journal.
L’utilisateur édite. Le système décide proprement quoi versionner.
L’historique reste lisible, et le journal du document raconte aussi ses circuits de validation.
8. Les métadonnées d'archivage, dès la capture
L’archivage n’est pas une étape de fin de vie qu’on découvre trop tard.
Chaque type porte sa durée de conservation, son sort final, sa base légale, posés dès la capture sur le document.
Le radar des échéances signale ce qui arrive à terme.
La GED devient conforme par construction, pas par chantier de rattrapage.
Pour la DSI et le RSSI : les atouts d'architecture
Les huit points précédents parlent aux métiers. Ceux qui suivent s’adressent à la DSI et au RSSI. Le choix final se joue toujours là aussi.
- Capture omnicanale, une seule chaîne. Batch (zip ou volume monté), boîtes mail (une adresse = un domaine), connecteur GED → GED (reprise CMIS depuis Alfresco, Nuxeo, MultiGest, Documentum, …), dépôt au fil de l’eau depuis l’Explorer et l’API. Pas cinq outils : un.
- Le système apprend en continu. Chaque arbitrage humain enrichit les motifs et les exemplaires. Plus on l’utilise, plus il classe seul, moins il appelle le LLM.
- Capitalisation inter-clients. Un modèle documentaire (domaines, types, motifs, sensibilité, règles d’archivage, vues) est versionné et livré en pack d’un projet à l’autre. L’import « sans écrasement » propose les nouveautés à accepter ou refuser, sans détruire le réglage local. Des packs existent déjà pour la MDPH, les RH, le commercial, les projets et les alertes sanitaires.
- Souveraineté et RGPD par défaut. L’IA tourne entièrement en local. Pseudonymisation par PromptCape quand on fait appel à un modèle distant, et classes de sensibilité qui interdisent ce départ pour les documents qui ne doivent pas sortir.
- Reprise de l’existant. Adoption in situ des documents déjà présents, sans re-dépôt, et migration GED → GED outillée. On ne repart pas de zéro.
- Sécurité mesurée, pas déclarée. Grille OWASP ASVS niveau 2, liste de contrôle Electron, hygiène ANSSI : chaque exigence a un statut et une preuve. Dépendances, secrets, configuration et images sont scannés à chaque livraison, bloquée sur une vulnérabilité critique. Aucun mot de passe par défaut, verrouillage après échecs, journal d’audit, sauvegardes dont la restauration est testée. Le dossier d’homologation s’appuie sur des faits.
- Résilience par conception. Client sans montage réseau : rien à chiffrer sur un lecteur mappé. Versions, corbeille, journal, restauration éprouvée. La GED devient un point de résilience, pas une surface d’attaque.
- Déploiement Kubernetes et OpenShift par chart Helm. Toute la pile (dépôt, recherche, chaîne de capture, client web, fournisseur d’identité, éditeur en ligne, serveur d’inférence, pseudonymiseur) s’installe et se met à jour par un seul chart, publié dans un registre, sur Kubernetes (Ingress) comme sur OpenShift (Route, SCC). Images sans privilège en système de fichiers lecture seule, NetworkPolicies qui n’ouvrent que les flux nécessaires, secrets fournis par le cluster, règles de disponibilité et montée en charge, site de secours actif/passif avec sauvegarde, restauration et ré-indexation documentées. L’exploitation se fait avec les outils de la DSI, pas avec les nôtres.
- Pas de lock-in éditeur. Le socle est Alfresco ACS standard, par ses API et CMIS. La chaîne de capture sait aussi déposer directement dans Efalia Doc, d’autres cibles à venir. Vous n’êtes prisonnier ni d’un format, ni d’un éditeur.
- Océrisation à la capture. Avec un modèle local de vision, les PDF numérisés sont océrisés au chargement. Leur texte alimente la classification et la recherche.
- Des briques que personne n’attend d’une GED. Contrôle de fraude documentaire (clés NIR et MRZ, incohérences de fichier), découpage des lots numérisés par intercalaires à code-barres, détection d’échéances, dédoublonnage, listes de valeurs branchées sur vos référentiels (CRM, projets). La différence entre une démo et une production.
| Éditeurs GED (Alfresco, Efalia, SharePoint, ...) | IA add-on (assistants type chatbot) | blueDoc + docLoader + GED Explorer | |
|---|---|---|---|
| Classement | manuel, plan de classement à maintenir | manuel (l'IA commente) | automatique, métadonnées et vues métier, apprenant |
| Organisation | arbre unique figé | arbre unique figé | vues recomposables, multi-domaine |
| Recherche | mots-clés, arborescence | chatbot | langage naturel : filtres métier + texte + sémantique, en local |
| Interface | portail générique à apprendre | fenêtre de chat en plus | explorateur familier, accessible RGAA (poste aujourd'hui, web à venir) |
| Sécurité | ACL, héritage, et rôles techniques | ACL, héritage et rôles techniques | sensibilité et zone, langage métier, mesurée par une grille ASVS |
| IA | cloud | cloud | locale par défaut, distante pseudonymisée en option, multi-documents |
| Archivage | module séparé | absent | intégrée dès la capture (durée, sort, base légale) |
| Données | selon éditeur stockage local ou cloud | sortent vers le modèle distant | peuvent ne jamais sortir selon configuration et, si sortie autorisée pour la sensibilité de la données, toujours pseudonymisées |
Les questions qui dérangent (à poser à votre GED actuelle)
- Combien d’heures par an vos collaborateurs passent-ils à ranger des documents ? Et combien à en chercher ?
- Votre plan de classement est-il à jour ? Qui le maintient ? Que se passe-t-il quand deux services le veulent différent ?
- Vos collaborateurs continuent-ils à s’envoyer les documents hors GED ?
- Quelle est la bonne version de vos documents importants ? Est-elle dans la GED, ou sur des disques partagés et personnels ?
- Quand vous ajoutez « de l’IA », retire-t-elle du travail aux utilisateurs, ou leur en donne-t-elle un nouveau ?
- Vos données sensibles doivent-elles sortir de votre infrastructure pour bénéficier de l’IA ?
- Votre GED est-elle une cible pour un ransomware, ou un point de résilience ?
- Votre fournisseur peut-il prouver sa sécurité, exigence par exigence ?
La bonne question n’est pas « quelle GED a de l’IA ? ». C’est « quelle approche fait disparaître la corvée GED ? ». C’est là que vingt ans de terrain, et non un effet d’annonce, font la différence.